Change Failure Rate и связь с другими DevOps-метриками
Change Failure Rate работает не изолированно — эта метрика тесно связана с тремя другими показателями DORA. Вместе они создают полную картину производительности DevOps-команды, показывая как скорость разработки, так и стабильность результата.
Deployment Frequency
Deployment Frequency измеряет, как часто команда выпускает код в продакшн. Между CFR и частотой деплоев существует сложная взаимосвязь. Команды иногда пытаются снизить Change Failure Rate, уменьшив количество релизов. Логика кажется простой: меньше деплоев — меньше возможностей для ошибок. Но такой подход ведет к противоположному результату.
Редкие релизы содержат больше изменений, что увеличивает сложность и риск сбоев. Если команда деплоит раз в месяц, каждый релиз включает недели работы разных разработчиков. При возникновении проблемы сложно быстро найти причину и исправить ее.
Лучшие команды совмещают высокую частоту деплоев с низким CFR. Они выпускают небольшие изменения несколько раз в день, что упрощает тестирование и откат при проблемах.
Lead Time for Changes
Lead Time for Changes показывает время от коммита до деплоя в продакшн. Эта метрика напрямую влияет на Change Failure Rate через качество процессов разработки.
Длинный Lead Time часто означает медленные процессы тестирования, ревью и развертывания. Разработчики накапливают изменения, стараясь сократить количество «тяжелых» релизов. Это приводит к крупным деплоям с высоким риском сбоев.
Короткий Lead Time заставляет команду автоматизировать процессы и делать их надежными. Если от коммита до продакшена проходит час, команда не может позволить себе ручное тестирование или сложные процедуры развертывания. Команды с коротким Lead Time обычно имеют низкий CFR благодаря зрелым практикам автоматизации и контроля качества.
Time to Restore Service
Time to Restore Service измеряет скорость восстановления после инцидента. Эта метрика работает в паре с CFR, показывая не только частоту проблем, но и готовность команды их решать.
Высокий CFR при низком времени восстановления говорит о том, что команда быстро реагирует на сбои, но не устраняет их причины. Команда «тушит пожары», но не улучшает процессы. Низкий CFR при высоком времени восстановления указывает на редкие, но серьезные проблемы. Команда хорошо предотвращает большинство сбоев, но плохо готова к нестандартным ситуациям.
Идеальная ситуация — низкие показатели по обеим метрикам. Команда выпускает стабильный код и быстро решает редкие проблемы.
Почему важен комплексный подход к оценке DevOps-команд
Изолированная оценка по одной метрике дает искаженную картину и может привести к неверным решениям. Команды начинают оптимизировать показатель, не понимая влияния на общую производительность.
Четыре метрики DORA работают как система сдержек и противовесов. Deployment Frequency и Lead Time показывают скорость, Change Failure Rate и Time to Restore Service — стабильность. Улучшение в одной области не должно происходить за счет деградации в другой. Комплексный подход помогает выявить дисбаланс в команде. Высокая частота деплоев при высоком CFR говорит о проблемах с качеством. Низкий CFR при редких релизах указывает на излишнюю осторожность, которая замедляет доставку ценности.
Элитные команды добиваются высоких показателей по всем четырем метрикам одновременно. Они часто деплоят, быстро доставляют изменения, редко сталкиваются со сбоями и быстро их устраняют. Такой баланс достигается через зрелые практики автоматизации, тестирования и мониторинга.
Измерение только CFR без контекста других метрик может привести к ложным выводам о здоровье процессов разработки.
Инструменты для работы с CFR
Эффективное отслеживание Change Failure Rate требует правильного набора инструментов для сбора данных о релизах и инцидентах. Команды должны автоматизировать процесс измерения CFR, чтобы получать точные и своевременные данные.
Системы мониторинга и алертинга
Инструменты мониторинга фиксируют проблемы в продакшене и связывают их с конкретными релизами. Настройте алерты, которые срабатывают при отклонениях от нормального поведения системы. Примеры таких решений включают системы сбора метрик и визуализации данных.
Важно настроить мониторинг не только инфраструктуры, но и пользовательского опыта. Синтетические тесты проверяют критические сценарии использования и выявляют проблемы до того, как их заметят пользователи.
CI/CD платформы с отслеживанием деплоев
Системы непрерывной интеграции и доставки автоматически фиксируют каждый релиз с отметкой времени. Интегрируйте пайплайны с системами мониторинга, чтобы автоматически связывать деплои с последующими инцидентами. Настройте автоматический откат при обнаружении проблем. Если мониторинг показывает критические ошибки после деплоя, система должна самостоятельно вернуться к предыдущей версии.
Системы управления инцидентами
Платформы управления инцидентами помогают классифицировать и отслеживать сбои. Каждый инцидент должен быть связан с релизом, который его вызвал. Автоматизируйте создание постморемов после каждого инцидента. Документируйте причины сбоя, время восстановления и меры по предотвращению повторения проблемы.
Аналитические дашборды DORA-метрик
Специализированные платформы автоматически собирают и визуализируют все четыре метрики DORA. Они интегрируются с различными инструментами разработки и дают готовые отчеты. Создайте дашборды, которые показывают тренды CFR во времени, разбивку по командам и корреляцию с другими метриками. Команда должна видеть влияние своих улучшений на показатели качества.
Комплексные системы управления жизненным циклом разработки
Интегрированные решения упрощают отслеживание CFR за счет объединения всех процессов в единой платформе. Например, SimpleOne SDLC объединяет управление релизами с отслеживанием инцидентов через интеграцию с ITSM-системой.
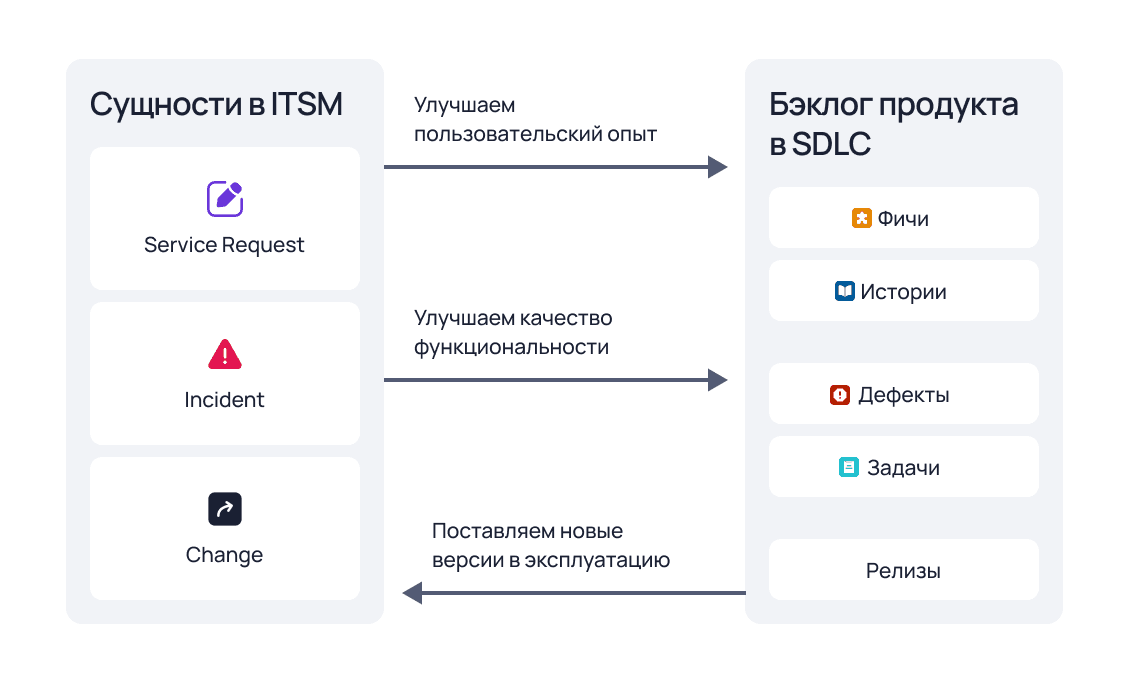
Такие решения автоматически связывают задачи разработки с релизами, а релизы — с инцидентами. Когда пользователь сообщает о проблеме через Service Desk, система определяет, какой релиз мог ее вызвать. Дефекты из ITSM попадают в бэклог продукта, создавая замкнутый цикл улучшения качества.
Выбор конкретных инструментов зависит от размера команды, технологического стека и бюджета. Главное — обеспечить автоматический сбор данных и их интеграцию для получения точной картины Change Failure Rate.
Кратко о CFR
- CFR измеряет долю релизов, которые приводят к сбоям в продакшене. Метрика входит в четыре основных показателя DORA и отражает качество процессов контроля до выпуска кода пользователям.
- Формула расчета: разделите количество неудачных релизов на общее количество релизов за период, умножьте на 100%. Неудачным считается релиз, который вызвал инцидент, потребовал отката или нарушил работу пользователей.
- Четыре уровня производительности команд: элитные команды поддерживают CFR в диапазоне 0-15%, высокопроизводительные — 16-30%, средние — 46-60%, низкоэффективные — выше 60%. Каждый уровень отражает зрелость процессов тестирования и контроля качества.
- CFR работает в связке с Deployment Frequency, Lead Time for Changes и Time to Restore Service. Изолированная оптимизация одного показателя может навредить общей производительности — нужен баланс между скоростью и стабильностью.
- Используйте системы мониторинга, CI/CD платформы, управление инцидентами и аналитические дашборды. Комплексные решения вроде SimpleOne SDLC автоматически связывают релизы с инцидентами, создавая замкнутый цикл улучшения качества без ручного сопоставления данных.